Par David Saada · fondateur de DATAISTUDIO · mis à jour le
L'industrialisation d'un modèle de machine learning sur Google Cloud repose sur une chaîne outillée : BigQuery pour les données, Vertex AI pour l'entraînement et le monitoring, Cloud Run pour servir les prédictions. DATAISTUDIO conçoit et développe cette chaîne MLOps pour transformer un modèle testé en notebook en service fiable, versionné et surveillé en production.
MLOps : définition et enjeux pour l'entreprise
Le MLOps (Machine Learning Operations) désigne l'ensemble des pratiques qui permettent de déployer, surveiller et faire évoluer des modèles de machine learning en production de façon fiable et reproductible. Le terme s'inspire du DevOps mais répond à des problématiques propres au ML : versionner les données autant que le code, valider la performance avant mise en service, détecter la dérive d'un modèle dans le temps.
Sur Google Cloud, cette discipline s'appuie sur des services managés. Vertex AI Pipelines orchestre le cycle de vie du modèle sous forme de workflow reproductible, BigQuery sert de source de vérité pour les données d'entraînement et de scoring, et Cloud Run permet d'exposer un modèle comme une API conteneurisée, facturée à l'usage.
L'enjeu n'est pas seulement technique. Un modèle qui reste dans un notebook ne produit aucune valeur métier. Le MLOps est la condition pour qu'un score de crédit, une prévision de demande ou une détection de fraude alimente réellement une décision opérationnelle, jour après jour.
Problèmes métier concrets rencontrés sans MLOps
Les entreprises qui développent des modèles sans cadre d'industrialisation rencontrent des difficultés récurrentes, souvent invisibles tant que le volume reste faible.
Un modèle entraîné une fois dans un notebook perd en performance au fil du temps sans que personne ne s'en aperçoive : c'est la dérive, ou drift. Les prédictions deviennent silencieusement moins fiables, avec un impact direct sur le risque ou le revenu selon le cas d'usage.
Le passage en production repose souvent sur une personne ou un script isolé, difficile à auditer, à faire évoluer ou à transmettre. Le réentraînement, lorsqu'il a lieu, se fait manuellement, avec un risque d'erreur et un délai incompatible avec un usage métier régulier.
Cas d'usage industrialisables sur Google Cloud
| Cas d'usage | Données sources | Composant clé |
|---|---|---|
| Scoring crédit ou risque | BigQuery, données contractuelles | xgboost entraîné et versionné sur Vertex AI |
| Détection de fraude ou d'anomalie | Flux transactionnels BigQuery | Pipeline Vertex AI avec réentraînement périodique |
| Prévision de demande | Historique des ventes | Modèle déployé en batch sur Cloud Run |
| Application interne data-driven | BigQuery + logique métier | Interface Shiny servie via Cloud Run |
| Assistant ou agent IA générative | Documents, bases de connaissance | Gemini sur Vertex AI, orchestration applicative |
Approche DATAISTUDIO, étape par étape
DATAISTUDIO intervient en mission de conseil et de développement, sur des durées de quelques semaines à quelques mois, pour construire ou fiabiliser une chaîne MLOps adaptée au contexte de l'entreprise.
- Audit du modèle existant et de son environnement de données : qualité, volumétrie, fréquence de mise à jour disponible sur BigQuery.
- Conception du pipeline d'entraînement : préparation des données, entraînement (xgboost ou autre selon le cas), évaluation automatisée avant promotion en production.
- Mise en place du déploiement sur Vertex AI ou Cloud Run selon la nature du service (prédiction batch, API temps réel, application Shiny).
- Instrumentation du monitoring : suivi de performance, détection de dérive, alerte en cas d'anomalie.
- Formation des équipes internes pour qu'elles puissent faire évoluer le pipeline de manière autonome.
Architecture type et fonctionnement
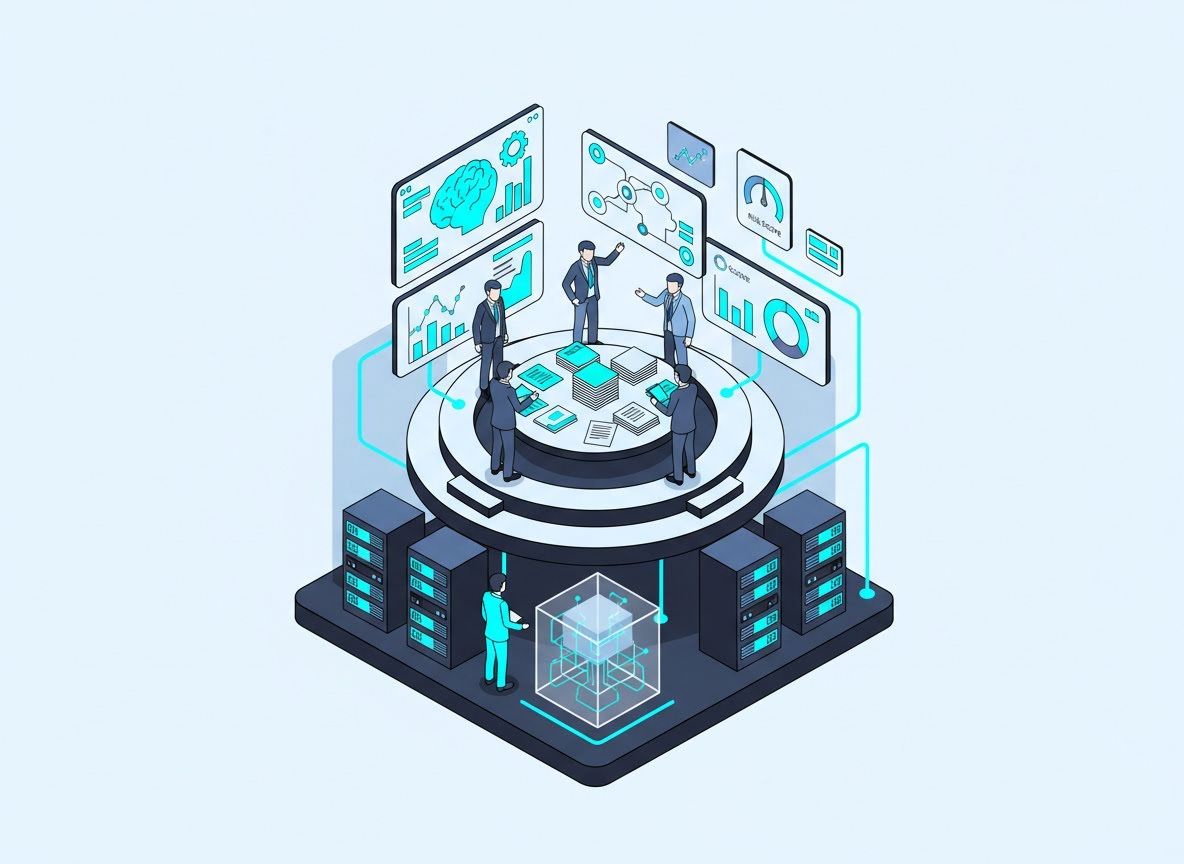
Une architecture MLOps sur Google Cloud articule généralement trois couches : la donnée, l'entraînement, le service. BigQuery centralise les données d'entraînement et de scoring et sert de source unique de vérité pour éviter les écarts entre environnements de développement et de production.
Vertex AI Pipelines orchestre le workflow sous forme de graphe reproductible : préparation des données, entraînement, évaluation, enregistrement du modèle dans un registre de versions, puis déploiement. Cette orchestration garantit qu'un même pipeline peut être rejoué à l'identique pour réentraîner un modèle sur des données plus récentes.
Pour la mise en production, Cloud Run permet d'exposer un modèle ou une application data (par exemple une interface Shiny) comme un service conteneurisé, scalable et facturé à l'usage réel. Pour les usages d'IA générative, Gemini s'intègre à cette même chaîne Vertex AI, avec les mêmes exigences de gouvernance que les modèles prédictifs classiques.
Cette approche architecture et stack est détaillée, avec ses arbitrages, dans l'article MLOps vs LLMOps en 2026 : comparatif de stacks pour industrialiser l'IA.
Bénéfices mesurables de l'industrialisation
Industrialiser un modèle change sa nature : il passe d'un livrable ponctuel à un service opérationnel. Les bénéfices se mesurent sur plusieurs axes complémentaires.
- Fiabilité : le modèle en production est le même que celui validé, avec une traçabilité des versions et des données d'entraînement.
- Réactivité : un réentraînement déclenché automatiquement sur dérive détectée, plutôt qu'une intervention manuelle tardive.
- Coût maîtrisé : des ressources de calcul allouées à la demande sur Vertex AI et Cloud Run, sans infrastructure dédiée à maintenir en permanence.
- Autonomie métier : des équipes internes formées pour piloter et faire évoluer la chaîne, plutôt que dépendantes d'un développeur unique.
Gouvernance, sécurité et conformité des modèles en production
L'industrialisation d'un modèle ne se limite pas à la performance technique : elle doit répondre aux exigences de gouvernance propres aux secteurs régulés. L'ACPR a structuré depuis 2020 ses attentes autour de quatre critères pour les algorithmes d'IA en finance : le traitement des données, la performance, la stabilité et l'explicabilité du modèle dans le temps.
La stabilité du modèle, c'est-à-dire sa résilience face à la dérive, et l'explicabilité des décisions figurent parmi les points d'attention constants des régulateurs. Un monitoring intégré au pipeline MLOps, avec détection de dérive automatisée, répond directement à cette exigence de surveillance continue.
Pour les cas d'usage réglementés comme le scoring crédit ou l'assurance, l'explicabilité doit être pensée dès la conception du pipeline et non ajoutée après coup. Ces enjeux sont développés dans l'article Explicabilité de l'IA en assurance vie : répondre à l'ACPR sans refondre le modèle, transposable à d'autres cas d'usage de scoring.
Exemple type d'industrialisation
Exemple type : une entreprise dispose d'un modèle xgboost de scoring, développé et validé par une équipe data en notebook, avec des résultats jugés satisfaisants sur un échantillon historique. Le modèle n'est pas en production : chaque nouveau scoring nécessite une exécution manuelle du notebook et un export des résultats.
DATAISTUDIO structure un pipeline Vertex AI qui automatise l'entraînement sur les données BigQuery mises à jour, évalue automatiquement le modèle avant toute promotion, puis déploie le service de scoring sur Cloud Run, consommable par les applications métier via une API. Un monitoring détecte la dérive de performance et déclenche une alerte pour réentraînement.
Ce type de démarche rejoint les principes appliqués sur les projets de scoring crédit par machine learning, où l'industrialisation conditionne l'usage réel du modèle par les équipes métier.
Pourquoi confier l'industrialisation de vos modèles à DATAISTUDIO
DATAISTUDIO est un cabinet français de conseil, développement et formation en data et intelligence artificielle, fondé en 2019 et basé à Neuilly-sur-Seine. L'équipe travaille directement sur la stack de production présentée ici : R, Shiny, xgboost, BigQuery, Vertex AI, Gemini et Cloud Run sur Google Cloud.
Cette maîtrise se traduit concrètement dans la Factory DATAISTUDIO, qui publie chaque jour des articles, des fiches algorithmes, des cas d'usage et des applications data générées et mises en production de façon automatisée. C'est une preuve directe de la capacité à faire tourner des modèles en continu, pas seulement à les concevoir.
Les missions se déroulent en conseil et développement, sur des durées de quelques semaines à quelques mois, avec une petite équipe et un réseau de partenaires mobilisable selon la taille du projet. Les équipes internes qui souhaitent monter en compétence peuvent suivre les formations certifiées Qualiopi, dont IA Analyst, dispensées en intra-entreprise.
Questions fréquentes
Quelle est la différence entre MLOps et LLMOps ?
Le MLOps couvre l'industrialisation des modèles de machine learning classiques (scoring, prévision, classification), avec un cycle entraînement-évaluation-déploiement-monitoring. Le LLMOps adresse des enjeux spécifiques aux modèles de langage : gestion des prompts, coûts d'inférence, évaluation de la qualité générative. Les deux approches cohabitent souvent dans une même stack Google Cloud, comme détaillé dans l'article MLOps vs LLMOps en 2026.
Faut-il obligatoirement utiliser Vertex AI pour faire du MLOps sur Google Cloud ?
Vertex AI n'est pas obligatoire mais il centralise les briques nécessaires (pipelines, registre de modèles, monitoring) et s'intègre nativement à BigQuery et Cloud Run. Certaines équipes combinent Vertex AI avec d'autres outils d'orchestration selon leurs contraintes existantes ; le choix dépend de l'architecture déjà en place dans l'entreprise.
Combien de temps dure un projet d'industrialisation MLOps ?
Les missions de conseil et de développement menées par DATAISTUDIO durent généralement de quelques semaines à quelques mois, selon la complexité du modèle, le volume de données et le niveau d'automatisation visé. Un pipeline simple de scoring peut être industrialisé plus rapidement qu'une chaîne multi-modèles avec monitoring avancé.
Le MLOps est-il nécessaire pour un seul modèle en production ?
Oui, dès qu'un modèle influence une décision métier récurrente, même un seul modèle justifie un minimum de MLOps : versionnement, évaluation avant déploiement, surveillance de la dérive. L'absence de ce cadre expose à des erreurs silencieuses difficiles à détecter sans monitoring dédié.
Comment le MLOps répond-il aux exigences réglementaires comme celles de l'ACPR ?
L'ACPR attend une attention portée à la stabilité et à l'explicabilité des algorithmes tout au long de leur cycle de vie, pas seulement au moment de leur conception. Un pipeline MLOps avec monitoring de dérive et traçabilité des versions répond directement à cette exigence de surveillance continue.
Industrialiser un modèle en production
DATAISTUDIO conçoit votre pipeline MLOps sur Vertex AI, BigQuery et Cloud Run, du modèle testé au service en production surveillé.
Échanger avec DATAISTUDIO →Sources
- Vertex AI Pipelines – Introduction (Google Cloud) (docs.cloud.google.com)
- Gouvernance des algorithmes d'intelligence artificielle dans le secteur financier (ACPR, juin 2020) (acpr.banque-france.fr)
- Tech Sprint sur l'explicabilité des algorithmes – Rapport de synthèse (ACPR) (acpr.banque-france.fr)